Hermès, mon outil d’automatisation, lit les messages que je lui envoie sur Telegram. Quand je le reprends, par un reproche, une consigne durable ou une erreur signalée, un agent hebdomadaire transforme la correction en règle. Pour les repérer, une regex attrape les formules évidentes et Claude Haiku lit ce qu’elle laisse passer. J’avais comparé Haiku à la regex, jamais à un modèle entraîné. J’ai voulu vérifier si un modèle classique, entraîné sur mes propres messages, ferait aussi bien, plus vite et gratuitement. Le code et la méthode sont publics sur GitHub, sans aucun de mes messages.
Les détecteurs et l’étiquetage
J’ai noté sur les mêmes 260 messages :
- la regex de production ;
- Haiku, appelé comme en production ;
- le pipeline actuel, regex puis Haiku ;
- une régression logistique sur TF-IDF ;
- CamemBERT, un modèle de langue français de 110 millions de paramètres, fine-tuné avec PyTorch.
Claude Opus a étiqueté les 260 messages sans voir les réponses des autres détecteurs, puis j’ai tranché moi-même 80 cas sur Telegram : les désaccords, les étiquettes où Opus doutait, et 20 messages tirés au hasard. Les deux modèles entraînés passent par une validation croisée en cinq parts, sans jamais voir le message qu’ils notent, et chaque score porte un intervalle de confiance à 95 %.
Les résultats
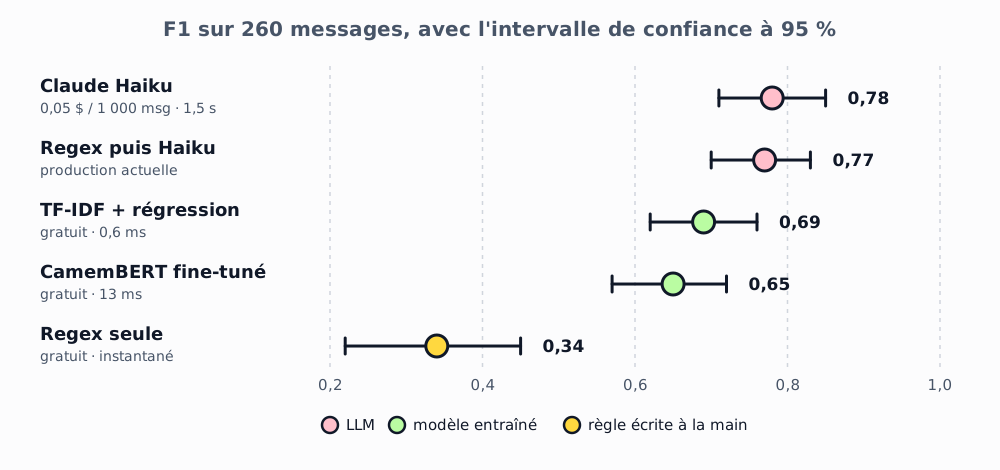
Avec 92 corrections dans le jeu, deux scores proches ne se départagent pas à l’œil, alors j’ai aussi comparé les détecteurs deux à deux sur les mêmes messages. Sur cet échantillon, Haiku devance nettement la regex (0,45 de F1) et CamemBERT (0,13). Face à TF-IDF, l’écart de 0,09 est réel mais son intervalle descend presque à zéro : je ne parierais pas sur sa taille.
Ce que ces chiffres permettent de dire
Peu de choses au-delà de mon cas. 260 messages d’une seule personne, en français, sur une seule tâche : les intervalles sont larges, un écart de quelques centièmes ne prouve rien, et rien ne dit que l’ordre tiendrait sur d’autres données. Les modèles entraînés n’ont vu qu’environ 200 exemples chacun, ce qui avantage le LLM. Ces résultats décrivent ce qu’on obtient avec peu d’étiquettes, pas le plafond de chaque approche.
Pour Hermès, ils donnent une direction :
- garder Haiku se justifie. À mon volume, 260 messages en cinq mois, il coûte quelques centimes par an au tarif de l’API, et il reconnaît une critique de ton formulée sans tournure toute faite, là où la regex n’attrape qu’un cinquième des corrections ;
- la regex devant Haiku semble superflue : Haiku retrouve 19 de ses 20 corrections, et elle a ajouté une correction pour trois fausses alertes. C’est un argument pour la retirer, à confirmer sur les messages des prochains mois ;
- CamemBERT ne fait pas mieux que TF-IDF ici, ce qui n’a rien d’étonnant avec 200 exemples pour 110 millions de paramètres.
Quand le choix serait différent
TF-IDF finit 0,09 derrière Haiku et répond en une milliseconde, gratuitement, sans rien envoyer hors de la machine. Avec quelques centaines d’étiquettes de plus, des millions de messages par jour ou des données qui ne doivent pas sortir, la balance pencherait probablement de son côté. Le même banc, sur un autre volume ou une autre contrainte, pourrait conclure autrement, et c’est pour ça qu’il faut le faire tourner plutôt que présumer.
Ce que la mesure ne voit pas
Près de la moitié des corrections que Haiku rate n’existent que par la conversation :
- une relance de deux mots après un échec ;
- un renvoi vers une capture d’écran envoyée plus tôt ;
- un rappel que quelque chose était déjà fait.
Aucun détecteur qui lit un message et la fin de la réponse précédente ne peut les voir. Donner plus de contexte semble une piste plus prometteuse que changer de modèle, mais je ne l’ai pas encore mesuré.
L’autre limite, c’est moi. Sur les 20 messages tirés au hasard, là où Opus, la regex et Haiku étaient d’accord, j’ai contredit Opus quatre fois, et certains de mes propres arbitrages se contredisent. Au-delà de 0,8, ce banc mesure sans doute autant l’accord entre annotateurs que la qualité des détecteurs.
Si vous envisagez un LLM pour trier, classer ou détecter, on peut comparer sur vos données ce qu’il apporte face à des solutions plus simples. Ce n’est pas toujours lui qui gagne.