Argos, mon CRM, appelle un LLM dans une dizaine de background jobs : résumer les pièces jointes des mails, rattacher un mail ou un compte rendu Granola au bon deal, enrichir une fiche de prospect, extraire les entreprises de l’annuaire de la CCI du Finistère. Jusqu’au 14 octobre, chaque appel passait par une API payante, Mistral Medium chez Scaleway ou Claude Haiku chez Anthropic. Du 12 au 14 octobre, le compte Anthropic est resté à sec et 21 résumés de documents ont attendu. Mon abonnement Claude Max tournait déjà sur mon Mac pour Hermès, mon outil d’automatisation.
Une table de tâches dans Argos, un démon sur le Mac
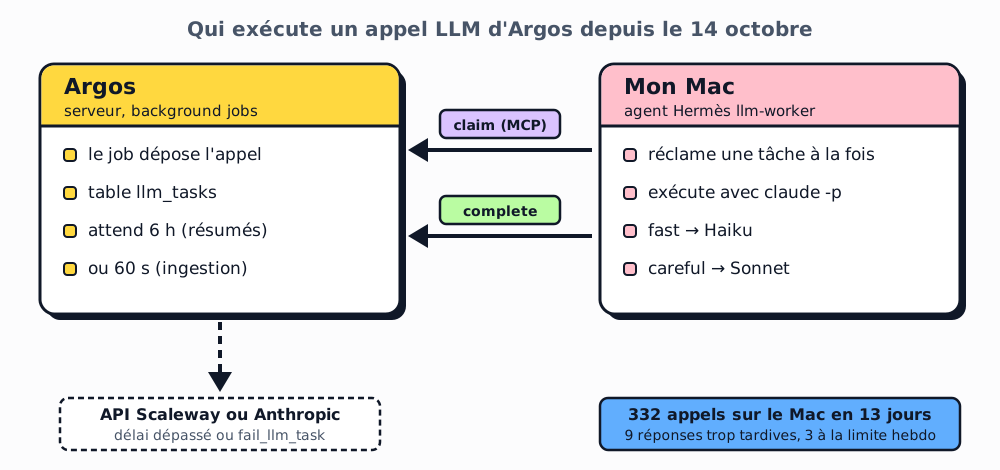
Argos tourne sur un serveur et ne peut pas joindre mon Mac, qui se déplace, se met en veille et change de réseau, donc j’ai inversé le sens. Argos écrit chaque appel dans une table llm_tasks, avec les messages, les pièces jointes et une échéance, et un démon sur le Mac vient les réclamer par le serveur MCP d’Argos, celui que j’utilise déjà pour piloter le CRM. Il expose trois outils, claim_llm_task, complete_llm_task et fail_llm_task. Le claim pose un bail de dix minutes, et les pièces jointes arrivent en URL signées valables aussi dix minutes.
Le démon, llm-worker, est un agent Hermès lancé par launchd. Il réclame une tâche, la passe à claude -p et renvoie la réponse.
Chaque service d’Argos déclare un niveau, fast ou careful, que le Mac traduit en Haiku ou Sonnet. Quand un modèle local tournera sur un Mac Studio, seule cette ligne de configuration changera.
La bascule sur l’API
Une famille d’appels attend le Mac pendant un temps borné, puis Argos exécute l’appel lui-même avec l’API d’avant. Les résumés peuvent attendre six heures, et leur job se replanifie en attendant. L’ingestion (attribution des mails et des comptes rendus, enrichissement) attend 60 secondes dans le job. Un échec signalé par le Mac déclenche la bascule tout de suite.
Chaque famille est livrée coupée (delegate: false) et ne s’active qu’après un banc d’essai en production. Les résumés ont passé le leur le 14 octobre, sur 10 documents résumés en 4 à 9 secondes, aussi bien que par l’API. L’ingestion a échoué au premier essai. Le JSON était valide 20 fois sur 20, mais 3 résumés de mails sur 5 sont revenus en anglais pour des mails en français, et les justifications faisaient 50 à 70 mots au lieu de 40. Le prompt, écrit en anglais, ne précisait aucune langue, et Mistral répondait en français. En comparant, j’ai aussi vu que Mistral notait 249 de ses 259 suggestions d’attribution à 0,8 ou plus, juste au-dessus du seuil d’attribution automatique, et le prompt ne donnait aucune échelle. La langue, la longueur et l’échelle sont maintenant dans les prompts, pour les deux fournisseurs, et l’ingestion est passée au Mac après un second banc.
Treize jours en production
Du 14 au 27 octobre, le Mac a traité 332 appels, 243 d’ingestion et 89 résumés, en 4 secondes en médiane et 9 secondes au 90e centile. Sur la même période :
- 9 réponses d’ingestion sont arrivées après les 60 secondes, jusqu’à 147 secondes d’exécution ; Argos les a refusées, l’appel était déjà parti chez Scaleway ;
- le 16 octobre au soir, j’ai atteint la limite hebdomadaire de l’abonnement, et 3 tâches ont échoué en une seconde avant de partir sur l’API. Le démon devait alors se mettre en pause cinq minutes, il ne l’a pas fait :
claude -pécrivait « weekly limit », un libellé que ma liste de motifs ne connaissait pas.
Ce qui reste sur l’API
La prospection, qui note l’adéquation d’un prospect, et Reach, qui rédige mes brouillons de prospection, tournent encore sur Scaleway. Pour la première, je comparerai les classements de Mistral et de Claude sur le même jeu de prospects. Pour Reach, je relirai 20 brouillons régénérés avant d’activer quoi que ce soit, parce que le style d’écriture change d’un modèle à l’autre. Le budget de 60 secondes de l’ingestion reste serré pour les appels lents de claude -p. Le fournisseur local attend l’arrivée du Mac Studio.